OpenAI, บริษัทที่เป็นที่รู้จักทั่วโลกจากความสำเร็จของ ChatGPT, กำลังเตรียมการเคลื่อนไหวที่น่าประหลาดใจ: เปิดตัว social network ของตัวเอง
การตัดสินใจที่อาจดูแปลกสำหรับบริษัทที่เกิดขึ้นมาเพื่อพัฒนา intelligenza artificiale แต่กลับเผยให้เห็นถึงกลยุทธ์ที่ลึกซึ้งและมีเป้าหมายในยุคที่ข้อมูลมีค่าเท่ากับทองคำ
ไม่ใช่เพียงแค่การเข้าแข่งขันกับยักษ์ใหญ่อย่าง Meta หรือ X (อดีต Twitter) แต่เป็นการพิชิตพลังที่แท้จริงของยุคสมัยของเรา: การควบคุม ข้อมูลที่ผู้ใช้สร้างขึ้น.
สารบัญ
OpenAI เข้าสู่โลกของโซเชียลเน็ตเวิร์ก: ทำไมถึงตอนนี้?
ข่าวลือแรกพูดถึง ต้นแบบของ social network ที่อยู่ในขั้นตอนการพัฒนา ภายใน OpenAI
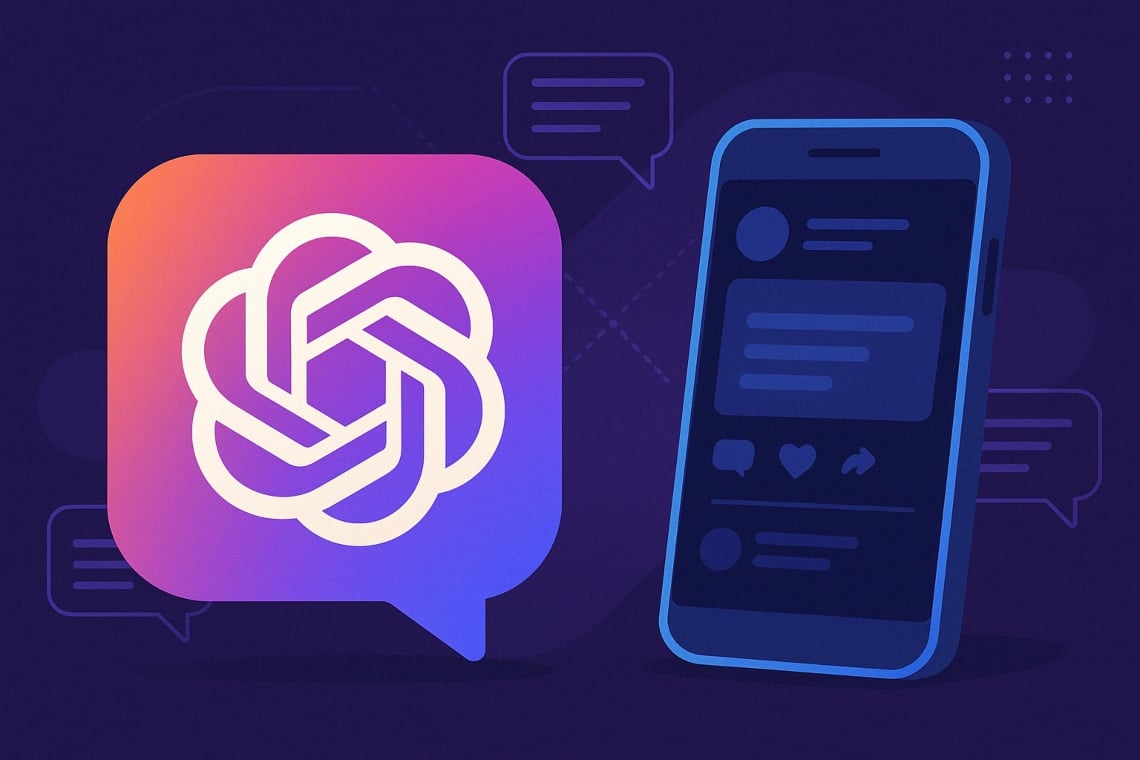
ที่ศูนย์กลางของโครงการ ความสามารถในการแบ่งปันเนื้อหาที่สร้างขึ้นผ่านปัญญาประดิษฐ์ โดยเฉพาะภาพที่สร้างโดย ChatGPT ใน ฟีดที่เลื่อน ได้ เช่นเดียวกับที่เกิดขึ้นบน Instagram หรือ TikTok
เป้าหมาย? เปลี่ยนการโต้ตอบกับ IA จากประสบการณ์ส่วนบุคคลไปสู่แพลตฟอร์มร่วมกัน ช่วงเวลาไม่ได้เป็นเรื่องบังเอิญ
ในปี 2025, ChatGPT มีผู้ใช้งานรายสัปดาห์มากกว่า 400 ล้านคน กลายเป็นแอปพลิเคชันที่มียอดดาวน์โหลดสูงสุดในโลก
ด้วยฐานผู้ใช้ที่มีอยู่แล้ว OpenAI อาจสามารถเปลี่ยนเปอร์เซ็นต์เล็กน้อยให้กลายเป็นผู้เข้าร่วมที่ใช้งานในเครือข่ายสังคมได้อย่างง่ายดาย ในจุดนั้น ความสำเร็จเริ่มต้นจะได้รับการรับประกันอย่างแท้จริง
นอกจากนี้ CEO Sam Altman ได้แสดงความสนใจต่อสาธารณะ แม้กระทั่งในลักษณะที่ยั่วยุ ต่อโลกโซเชียล เพื่อตอบสนองต่อโครงการ AI ของ Meta, Altman ได้เสียดสีเกี่ยวกับการพัฒนาแอปโซเชียลที่มีตรา OpenAI
ในที่สุด ความประชดประชันก็กลายเป็นการคาดการณ์ที่แท้จริง ทั้งหมดนี้ถูกเติมเต็มด้วยการแข่งขันส่วนตัว และสื่อ กับ Elon Musk ผู้ร่วมก่อตั้ง OpenAI และตอนนี้เป็นเจ้าของ X การท้าทายที่ไปไกลเกินกว่าเทคโนโลยี และแตะต้องสมดุลอำนาจระหว่างยักษ์ใหญ่แห่งนวัตกรรม
ความเชื่อมโยงระหว่างปัญญาประดิษฐ์และแพลตฟอร์มโซเชียลกำลังแน่นแฟ้นขึ้นเรื่อยๆ อุตสาหกรรมเทคโนโลยีกำลังมีส่วนร่วมในการแข่งขันอาวุธดิจิทัลใหม่ที่ทุกผู้เล่นพยายามครอบครองทั้งด้านการสื่อสารและAI
ตัวอย่างเช่น Meta กำลังผสานรวมผู้ช่วยดิจิทัลในแชทและเนื้อหาที่สร้างโดย AI ในฟีดของตน Elon Musk ได้เพิ่ม Grok ซึ่งเป็นแชทบอทที่พัฒนาด้วย xAI เข้าไปใน X แม้แต่ Snapchat ก็มี “เพื่อนเสมือน” ที่ขับเคลื่อนด้วย IA
ในขณะเดียวกัน บริษัทที่เชี่ยวชาญด้าน AI กำลังพยายามเข้าสู่พื้นที่สังคม ตัวอย่างเช่น OpenAI
Data wars: la vera posta in gioco
ในบริบทนี้ การสร้างเครือข่ายสังคมที่เป็นเจ้าของหมายถึง ควบคุมทั้งสื่อและข้อความ รวมโครงสร้างพื้นฐานและเนื้อหาไว้ภายในระบบนิเวศเดียว
ทุกคนต้องการเป็น “everything company” ของอนาคต: จาก Google ที่มี YouTube และ Gmail อยู่แล้ว ถึง Meta ที่จัดการเพื่อน, รูปภาพ และตอนนี้ยังมี avatar AI ด้วย
ในสถานการณ์นี้ OpenAI ต้องการเล่นเกมเดียวกัน หลังจากครองภาค AI แล้ว ขั้นตอนต่อไปคือการแทรกซึมเข้าไปในดินแดนของเครือข่ายสังคมเพื่อ เสริมสร้างอำนาจเชิงกลยุทธ์ เหนือข้อมูลและการโต้ตอบออนไลน์
แต่เหตุผลที่แท้จริงเบื้องหลังการเคลื่อนไหวนี้คืออะไร? คำตอบสรุปได้ในคำเดียว: ข้อมูล โซเชียลเน็ตเวิร์กไม่ใช่อะไรอื่นนอกจากแหล่งข้อมูลขนาดใหญ่
เนื้อหาทุกประเภทที่สร้างโดยผู้ใช้ ไม่ว่าจะเป็นโพสต์ รูปภาพ ความคิดเห็น หรือมีม ถือเป็น วัตถุดิบ ที่มีค่ายิ่งสำหรับการฝึก โมเดลปัญญาประดิษฐ์.
จนถึงวันนี้ OpenAI ต้องรวบรวมข้อมูลจากบุคคลที่สาม ซึ่งมักจะพบกับข้อจำกัดของ API คดีความ หรือค่าใช้จ่ายที่เพิ่มขึ้น Yahoo, Reddit และ X เองได้เริ่ม จำกัดการเข้าถึงฟรี ไปยังคลังข้อมูลดิจิทัลของพวกเขา
ด้วยเครือข่ายสังคมที่เป็นเจ้าของเอง OpenAI สามารถ สร้างกระแสข้อมูลอย่างต่อเนื่อง ปราศจากข้อจำกัดภายนอกและปรับให้เหมาะสมกับอัลกอริทึมของตนเองได้อย่างสมบูรณ์ ในทางปฏิบัติ การโต้ตอบของผู้ใช้ทุกครั้งกลายเป็น การสนับสนุนโดยตรงต่อการพัฒนา ChatGPT และระบบอื่นๆ ในอนาคต
และสิ่งนี้ ในช่วงการพัฒนาของ AI ในปัจจุบัน อาจทำให้เกิดความแตกต่างระหว่างการคงความเป็นผู้นำในภาคส่วนหรือถูก bull และ bear แซงหน้า
มุมมอง Web3: ระหว่างความตื่นเต้นและความระมัดระวัง
การสร้างโซเชียลไม่ได้หมายถึงแค่การรวบรวมข้อมูล: หมายถึงการ กำหนดกติกาของเกม ด้วย
ผู้ที่ครอบครองแพลตฟอร์มจะตัดสินใจว่าอะไรจะแสดง, อัลกอริทึมใดที่จะใช้ และวิธีการจัดการการสนทนาระหว่างผู้ใช้ หาก OpenAI สามารถทำให้เครือข่ายสังคมของตนประสบความสำเร็จได้, จะมี อิทธิพลอย่างมหาศาลต่อกระแสข้อมูล อยู่ในมือ
ในด้านหนึ่ง สถานการณ์นี้อาจดูเหมือนเป็นบวก ไม่มีใครดีกว่า OpenAI ในการแยกแยะระหว่างเนื้อหาจริงและปลอม ระหว่าง bot และผู้ใช้จริง
ตามทฤษฎีแล้ว เครือข่ายของพวกเขาอาจเป็น หนึ่งในเครือข่ายที่ปลอดภัยที่สุด สะอาดที่สุด และมีการควบคุมดูแลอย่างดี ที่เคยเห็นมา เนื้อหาที่เป็นอันตรายจะถูกบล็อกโดยอัตโนมัติ, troll จะถูกระบุทันที, ข้อมูลที่บิดเบือนจะถูกควบคุมก่อนที่จะแพร่กระจาย
ในทางกลับกัน การมอบ อำนาจทั้งหมดนี้ให้กับหน่วยงานเดียว ทำให้เกิดคำถาม ที่น่ากังวล อัลกอริทึมอาจให้ความสำคัญกับเนื้อหาที่เป็นประโยชน์ต่อภาพลักษณ์ของ ChatGPT หรือโพสต์ที่สามารถสร้างการโต้ตอบมากขึ้น (และดังนั้นจึงมีข้อมูลมากขึ้น)
เส้นแบ่งระหว่างสิ่งที่เป็นมนุษย์และสิ่งที่สร้างขึ้นโดย AI เสี่ยงที่จะสับสน ทำให้ผู้ใช้ตกอยู่ในความเมตตาของการเล่าเรื่องที่ถูกควบคุม ไม่ใช่โดยบรรณาธิการหรือผู้ใช้ แต่โดยโมเดลทางคณิตศาสตร์.